Keliweb vs SiteGround vs GoDaddy...
Este artículo fue escrito en italiano y traducido al español. Leer el original
Versión corta para los perezosos:
Para quien solo quiere una respuesta y no está interesado en leer todo mi análisis:
En el curso de mi análisis, SiteGround y GoDaddy como alojamientos compartidos de wordpress resultaron ser entre 10 y 20 veces más rápidos que Keliweb !!
Versión detallada (y extremadamente técnica):
Aclaro de antemano que nunca he sido fan de WordPress, pero por fuerza mayor tuve que empezar a ocuparme de él, y escribí este artículo como resultado de mi experiencia directa con Keliweb, a quien invito a contactarme para cualquier rectificación...
Todo nació del sistema de monitorización que uso ("MONITIS.COM") para vigilar otros sitios míos: empecé a recibir alarmas continuas de uno solo en particular, BURRACO.COM, que estaba precisamente en el alojamiento compartido WORDPRESS, con IP dedicada, en "Keliweb" - empresa que había elegido porque me habían hablado bien de ella.
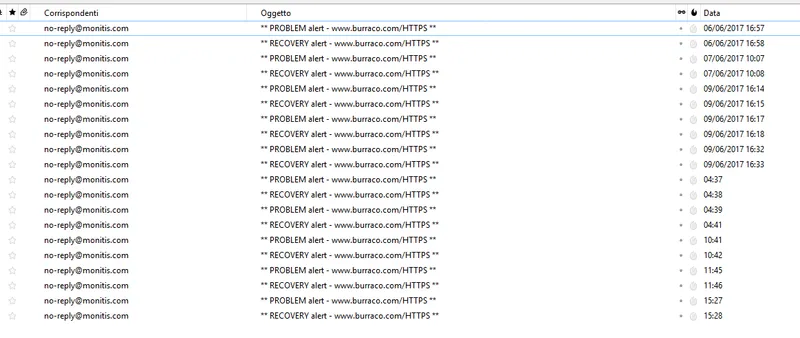
Tras una fase inicial en la que no entendía dónde estaba el problema, y después de algunos intercambios de mensajes con el soporte técnico de Keliweb, cuya solución siempre pasaba por proponerme que me mudara a un servidor "dedicado" (en lugar de intentar entender la naturaleza del problema), decidí profundizar yo solo en la cuestión, y hacer un pequeño análisis para luego comparar el rendimiento con otros dos grandes competidores: SiteGround por un lado (encontrado buscando en google) y GoDaddy (que conozco y uso desde hace años y en el que ya tengo otro sitio, también bajo WP en alojamiento compartido).
La configuración desde la que empiezo mi análisis es, por tanto, la siguiente (repito un poco todo): el sitio es www.burraco.com, alojado en KeliWeb en alojamiento compartido, con IP dedicada. Delante he puesto un CloudFlare que uso tanto para la seguridad como para la parte HTTPS - y, obviamente, no estoy usando la caché de contenidos.
Las herramientas que he utilizado para el análisis son: por un lado MONITIS.COM, que considero el mejor sistema de monitorización del momento, y que uso desde hace algo más de 10 años (cuando ni siquiera se llamaba así) y por otro lado simplemente Google Chrome en modo "debug".
Monitis en particular permite monitorizar una serie de servicios desde distintos centros de datos repartidos por el mundo. En mi caso, los que suelo elegir son Italia, España y US-EST porque me permite entender, cuando hay un problema, si es una cuestión limitada a problemas de conectividad europeos o si la cuestión se extiende también al otro lado del océano. Últimamente he añadido también Francia por varios motivos.
En cuanto a Google Chrome en modo "debug", fui a verificar los tiempos de carga de las páginas intentando entender dónde exactamente se producían más los problemas. Por si acaso, realicé las pruebas con Chrome desde puestos de escritorio situados en tres ubicaciones distintas: Malta, Roma y Florencia.
Para realizar las pruebas de forma imparcial, y excluyendo CloudFlare, apunté un MONITIS en HTTPS directamente a la IP de la máquina real (185.17.107.119), en Keliweb, modificando a mano la cabecera del GET añadiendo la cabecera "HOST" y haciéndola apuntar a www.burraco.com.
Posteriormente, creé una segunda monitorización, esta vez directamente en HTTP, porque por una cuestión de validación de los certificados SSL no siempre es posible entender, en caso de monitorización, qué está ocurriendo exactamente, así que apunté, en http, www.burraco.com, siempre con la cabecera modificada a www.burraco.com para evitar cualquier forma de redirección.
Ahora pasemos a los gráficos:
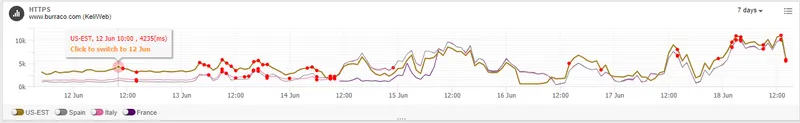
Este de arriba es el gráfico a una semana de distancia de la fecha de hoy, en HTTPS sobre IP directa, con el sitio todavía en Keliweb. Como los datos se recogen cada minuto, al alejar la vista al día y a la semana (como en este gráfico) se obtienen medias. Los puntos rojos representan los timeouts, que hasta la noche del 17/6 estaban configurados a 10 segundos (el valor por defecto de monitis) mientras que después los subí a 30 segundos para entender mejor qué ocurría. El tiempo en segundos aquí expresa el tiempo necesario para descargar hasta las cabeceras de respuesta de la página desde el servidor http (al menos esta es la explicación proporcionada por el soporte técnico de monitis). Monitis distingue, en efecto, entre monitorizaciones que hacen un análisis posterior del contenido de la página (por ejemplo, para verificar si una determinada cadena está presente en la página) y monitorización "pura" donde no interesa procesar el contenido de la página, sino solo ver si el sitio está UP. En el primer caso, obviamente, dicen que el tiempo se refiere a la descarga de toda la página html, sin más llamadas a imágenes, css u otros. En el segundo caso, es decir, solo monitorización sin verificación de contenido, MONITIS dice que el tiempo se calcula hasta la recepción de las CABECERAS de respuesta del servidor HTTP. Esto, obviamente, incluye también todas las demás fases, que son más o menos la suma de TCP_CONNECT + SSL_HANDSHAKE + http_REQUEST_SEND + http_REQUEST_RECEIVE + REDIRECTS. A mí no me convenció mucho que en un caso el tiempo se refiera a la llegada de las CABECERAS de respuesta del servidor http (también porque las CABECERAS no viajan en sockets paralelos, sino que viajan por el mismo SOCKET por el que se hizo la petición, al principio de la página HTML, pero esta consideración podría no tener nada que ver), pero por si acaso y para romper una lanza a favor de Keliweb, hagamos como si los tiempos incluyeran siempre también la descarga entera de la página html, no solo las cabeceras, siempre sin eventuales imágenes o css u otros.
Hechas todas estas aclaraciones, pasemos a analizar los resultados de las distintas pruebas.
En el gráfico publicado arriba, que se refiere exclusivamente al sitio alojado en Keliweb, se puede observar cómo los tiempos "medios" de espera de la respuesta de la página, en HTTPS, rondan los 6 segundos, con picos que por desgracia a menudo superan los 10 segundos, y a veces superan incluso los 30 segundos de espera (ver en particular después del 17/6, cuando cambié el timeout de 10 a 30 segundos, donde se aprecia mejor la tendencia).
Por si pudiera ser un problema de algún tipo ligado al HTTPS, monté también, como dije, una monitorización en HTTP, dirigida siempre a la IP del servidor de KeliWeb, modificando siempre las CABECERAS de la petición para incluir como HOST www.burraco.com, y este es el resultado:
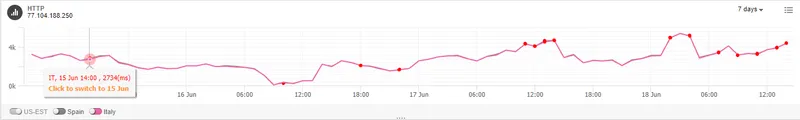
Parecería ir mejor, pero seguimos en torno a los 3 segundos de media (como media diaria), y también aquí con varios picos que superan los 10 segundos y los 30 segundos (esta vez configuré la monitorización directamente con timeout a 30). Pero veamos en detalle un gráfico, siempre de la misma monitorización, limitado a las últimas 24 horas para entender mejor lo que ocurre…
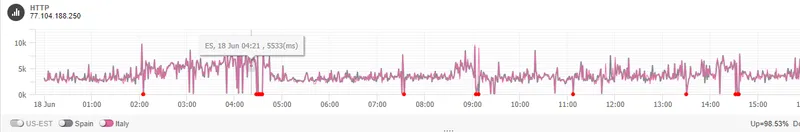
Este es el resultado… en la práctica siempre hay picos por encima de los 6 segundos, y a menudo se superan fácilmente los 30 segundos (los puntitos rojos), por lo que el gráfico en esos puntos concretos entra en timeout. Así que el problema no es el HTTPS, y de este modo hemos descartado cualquier duda sobre eventuales redirecciones de la versión http a la HTTPS. Además, el sitio está en cualquier caso configurado para navegarse en www.burraco.com y no en burraco.com, así que no hay ninguna redirección, 100% seguro, que pueda ralentizar el resultado.
Por si hubiera más dudas, hice también una verificación de las cabeceras enviadas y recibidas (no tengo captura de pantalla, lo siento), pero tampoco ahí detecté anomalías.
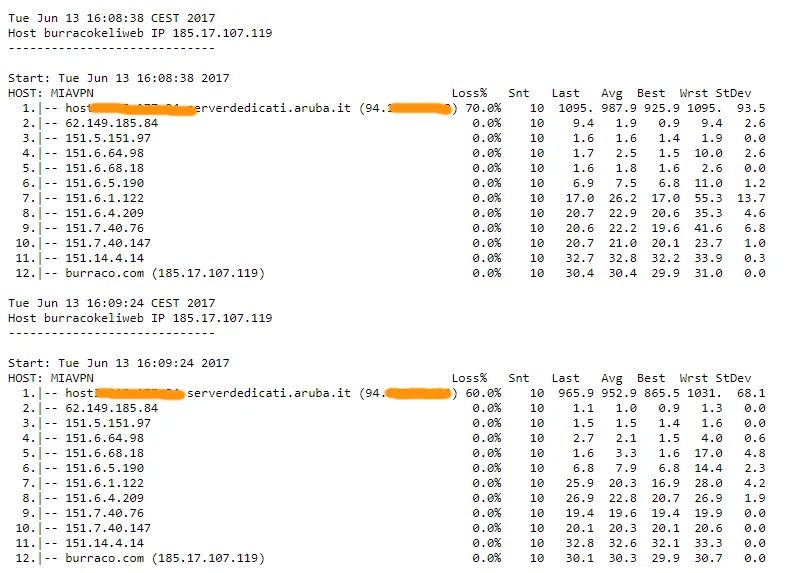
La duda que me quedaba en este punto era que se tratara de problemas relacionados con el enrutamiento (es decir, en el frente de redes) - por ese motivo añadí un trazado MTR desde otro servidor Linux mío que uso para estas cosas, el cual, mediante un script bash "personalizado", me proporciona cada minuto un informe detallado del enrutamiento. Esta herramienta, MTR, que quizá no es conocida por la mayoría, se usa en ámbitos profesionales normalmente para entender si ha habido un reencaminamiento causado, por ejemplo, por routers dañados o por la intervención de mecanismos especiales antiDDoS (los sistemas "vacuum" que reencaminan el tráfico a nivel de enrutamiento BGP). En resumen, es una especie de traceroute avanzado.
En el gráfico siguiente he ocultado deliberadamente, por razones de seguridad, la IP de mi máquina de origen, mi servidor Linux en Aruba. Sin embargo, el punto es que incluso durante las caídas, comprobé en los logs que el enrutamiento se mantuvo inalterado (incluso ampliando la vista a varias horas, para compensar posibles diferencias horarias entre servidores distintos), y no hay pérdida de paquetes.
Durante todas estas pruebas, tuve que llevar adelante (a veces con cierto esfuerzo) los intercambios de mensajes con el soporte de Keliweb, que cada vez achacaron el problema a algo distinto. Al principio nos dijeron que el problema era que la monitorización apuntaba a Cloudflare y que, por tanto, el problema estaba probablemente en CloudFlare, pero que en caso de problemas recomendaban... pasar a un dedicado. Cuando quitamos Cloudflare de la monitorización y apuntamos a la IP directa, nos comunicaron que nuestro sitio a menudo alcanzaba el 100% de CPU y, por tanto, recomendaban... pasar a un dedicado. Cuando demostramos que durante las caídas el consumo de recursos de nuestro servidor estaba por debajo del 8% (gráficos proporcionados por su propio sistema), nos dijeron que el problema estaba probablemente en nuestro sistema de detección, Monitis, aconsejándonos... pasar a un dedicado. Por mi parte hay que decir que me había obsesionado con que el problema fuera alcanzar un "timeout" por su lado (es decir, que las peticiones fueran en algún momento "descartadas"), mientras que luego entendí que estaba muy equivocado, porque ese "timeout" que veía provenía de alcanzar el umbral tolerable de respuesta en segundos, configurado en el timeout de monitis. Pero también es verdad, y es una opinión mía, que un sitio que tarda más de 10 segundos en responder debería hacer saltar de todos modos una alarma, sobre todo si tu empresa se dedica principalmente a vender precisamente alojamientos compartidos… si el tiempo empleado no coincide con un consumo excesivo, por parte de ese cliente, de los recursos del servidor. Porque si no, significa que me veo obligado a pasar a un servidor dedicado porque otro cliente está consumiendo demasiados recursos. Es un poco como tener que pagar una multa en la playa a ti, que no fumas, porque en el sitio donde estabas sentado otros dejaron colillas de cigarrillos.
Y aclaro, en cualquier caso, que, si el problema hubiera sido que efectivamente nuestro sitio ocupaba demasiados recursos, no habría tenido problema en coger un servidor dedicado. Pero el problema aquí seguía siendo la dificultad para encontrar una causa cierta, y yo quería encontrarla.
Estos que siguen son los gráficos del consumo de recursos proporcionados por el propio panel de Keliweb, unos 20 minutos después de una serie de timeouts, uno tras otro, detectados por MONITIS:
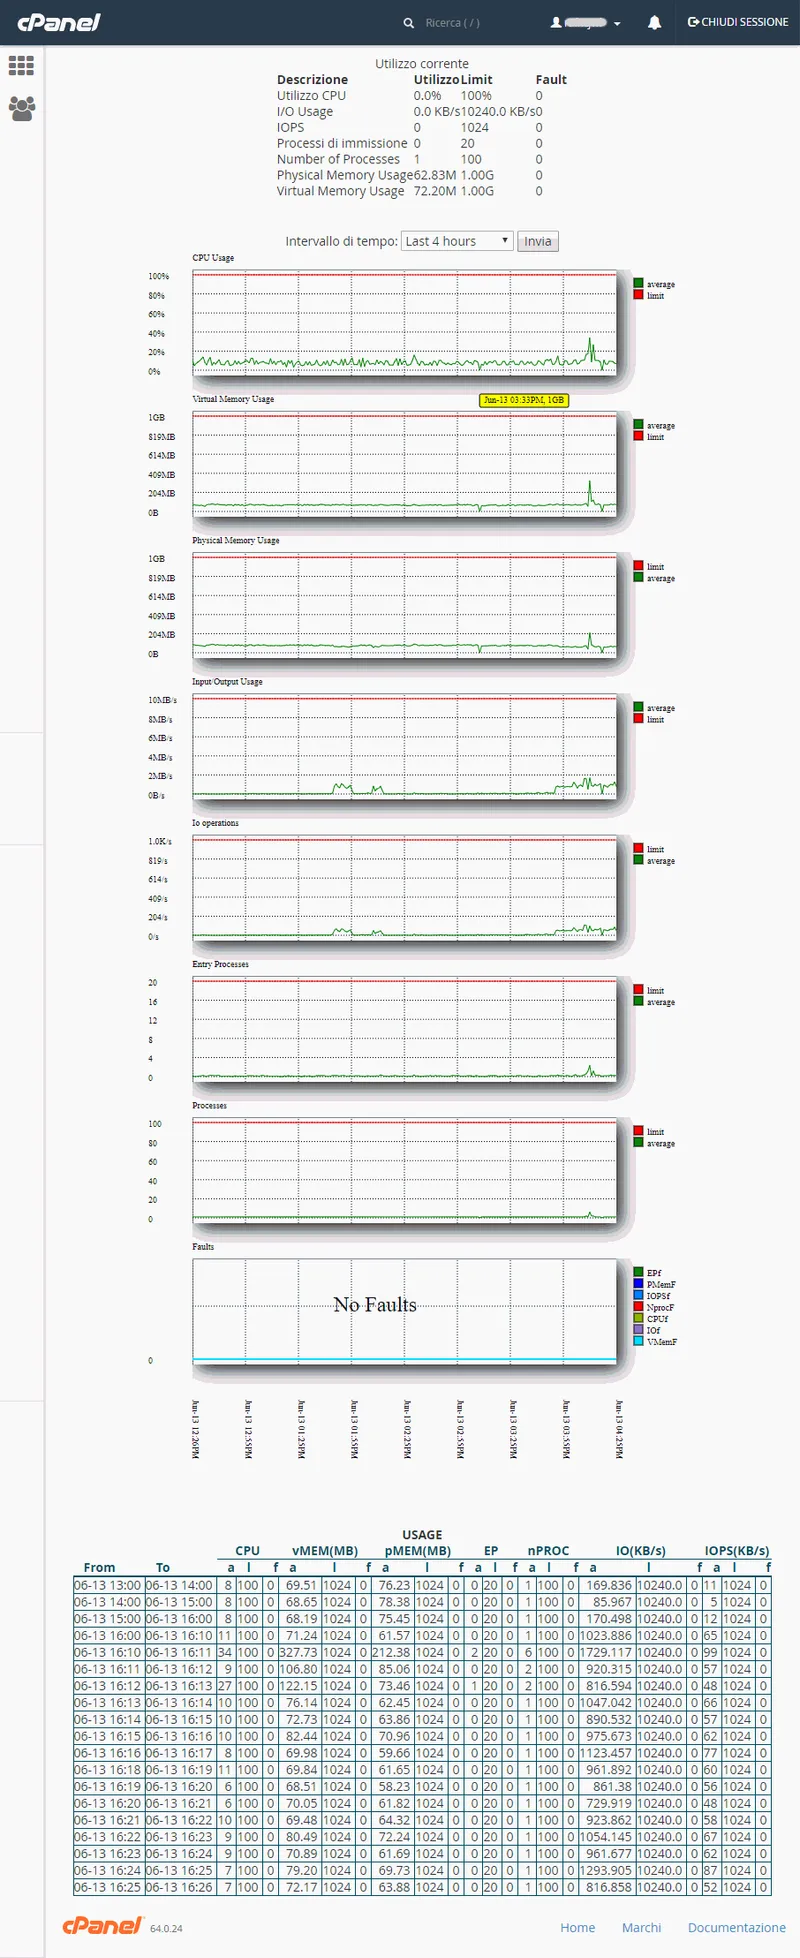
Entonces, excluyendo problemas de enrutamiento y problemas de ocupación excesiva (relativos a nuestra instancia) de CPU (salvo ese pico del 34% de las 16:10), ¿por qué seguía recibiendo problemas de carga tan largos y continuos ? ¿Quizá efectivamente la monitorización descarga de todos modos toda la página html, y quizá esta página tiene un montón de contenidos ? ¿O quizá es un problema solo de MONITIS y de las tres granjas web a la vez (US-EST, Italia y España) ? Para quitarme cualquier duda fui a verificar con Google Chrome en modo debug para ver los contenidos y, en detalle, los tiempos de descarga directamente desde mi PC (y más abajo también desde los de amigos). Estos son los resultados.
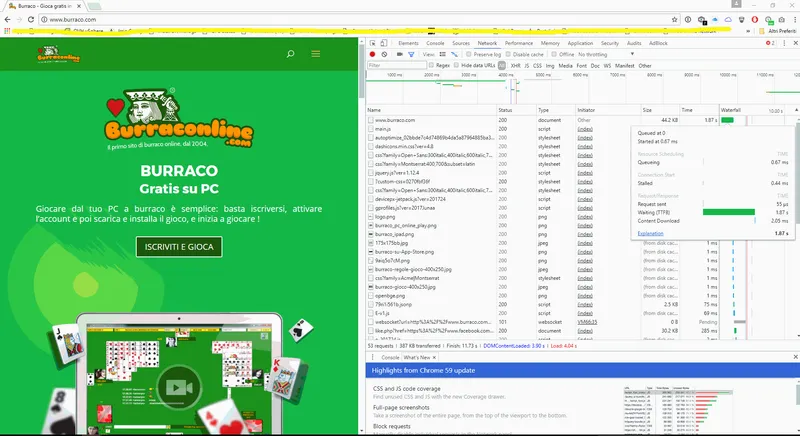
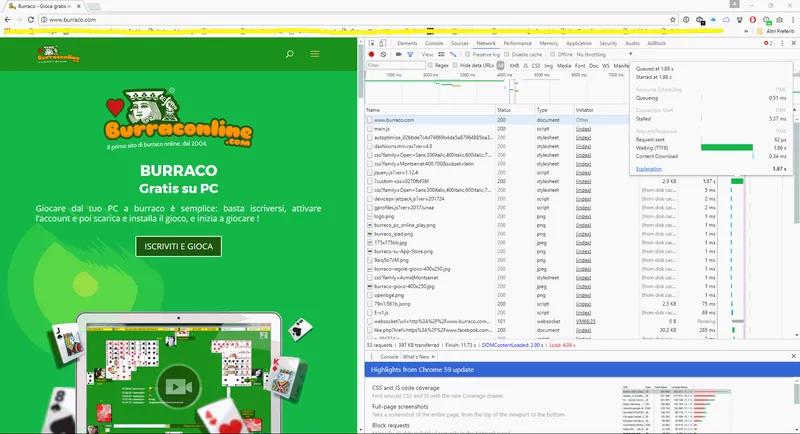
Hay que señalar que para hacer esta prueba modifiqué el archivo hosts de la máquina para que apuntara directamente a mi IP dedicada en Keliweb, para evitar posibles redirecciones y/o problemas ligados a CloudFlare, y apunté directamente a http:// en lugar de https://. El "DOMContentLoad" me da nada menos que 3,90 segundos (imagino que son 90 centésimas de 60 segundos, es decir, casi 4 segundos), lo que parece bastante en línea con la media de carga detectada por Monitis desde España, desde Italia y desde US-EST. Pero ¿por qué tarda tanto ? Teniendo en cuenta que el DOMContentLoad incluye también la fase de "conversión" del texto en la construcción del verdadero DOM, entendido como modelo de objetos, hay que decir que en este proceso inciden también la CPU y las prestaciones del PC. Pero la mía es una máquina de desarrollador, 1 CPU de 8 núcleos Intel i7 con 32GB de RAM, en discos SSD, y sobre todo muy descargada en cuanto a carga de recursos, así que si me atrevo a decir que la elaboración de un proceso así podría llevar 0,001 segundos (es decir, 1 milisegundo), quizá incluso estoy exagerando (en pesimismo).
Así que… sigamos … de un rápido análisis (y aquí no profundicé, en realidad aún habría mucho trabajo por hacer, empezando desde aquí) veo que hay un TTFB bastante alto, que es de 1.87 segundos. Es, en la práctica, el tiempo que tarda el servidor http en proporcionar el primer byte de respuesta. En la captura se ve que incluso para custom.css hicieron falta 1.86 segundos de TTFB. ¿Parecería, por tanto, un problema ligado a la sobrecarga de los servidores, que quizá no son capaces de satisfacer las peticiones en tiempos más breves porque están ocupados con otros recursos ? Por fin es la primera respuesta sensata y verificada que empiezo a aceptar…
En cualquier caso, la "descarga de contenido" tiene un valor más que aceptable: 0,34 ms. Así que, por un lado, la página html no ocupa un espacio excesivo, y por otro la conectividad, entendida como velocidad/ancho de banda, se confirma que está bien. Todo parecería confirmar, por tanto, la teoría de un simple problema de sobrecarga/configuración del servidor, y quizá solo del que me ha tocado a mí.
Queda aún una duda… ¿podría ser, además de un problema verificado desde tres ubicaciones distintas de Monitis, también un problema mío de conectividad/lentitud de descarga a internet ? Aclarando que tengo una fibra de 100Mbit, pero estoy en Malta, por si acaso realicé las mismas pruebas desde el PC "doméstico" de un amigo que está en Roma y que usa Telecom Fibra como conexión a internet… y los resultados son siempre los mismos, si no en algunos casos incluso peores:
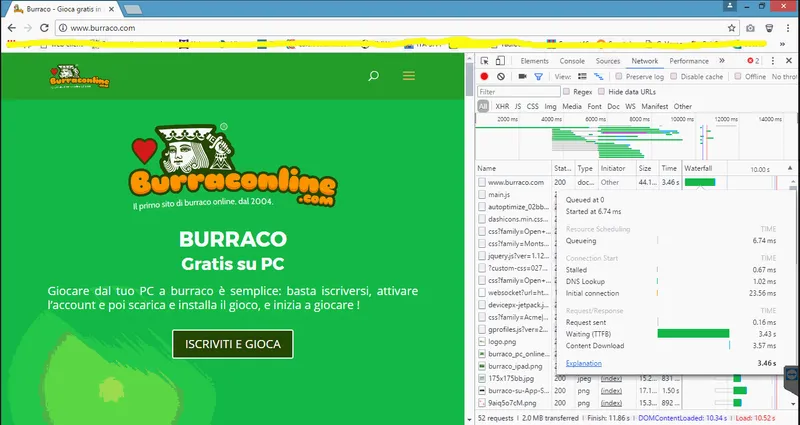
En la captura de arriba, hecha desde casa de mi amigo en Roma, se ve claramente un TTFB de 3,43 segundos … y un DOMCONtentLoaded de 10,34 segundos… lo que confirma una vez más que los datos tanto de MONITIS como de mi PC parecen ser todos correctos.
Vale, llegados a este punto me dije… "quizá estos son los datos normales de todas las empresas que hacen alojamiento compartido"… por si acaso, vamos a verificar qué ocurre en otro sitio mío de wordpress alojado esta vez en Godaddy:
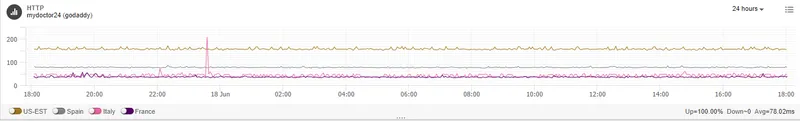
El gráfico me parece muy, muy lineal… no tiene todas esas histerias que tiene KeliWeb, y desde Italia tenemos incluso 36ms como tiempos de respuesta. El pico máximo fue a las 23:35, donde una única petición, desde Italia, tardó 209 ms. ¡¡ Una bonita diferencia frente a los aproximadamente 7 segundos de burraco.com que tengo en Keliweb !! es decir, un 97% menos de tiempo. Vale, pero se trata de un sitio distinto, seguro que habrá otros factores que podrían influir en el resultado … así que para hacer la prueba final … contraté un alojamiento con SiteGround, transferí todos los archivos de wordpress de burraco.com, transferí la base de datos y actualicé los DNS para que apuntaran a la nueva IP, sin cambiar NADA en los sistemas de monitorización. Solo la IP.
Este es el resultado:
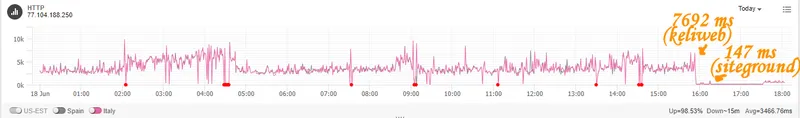
Los tiempos de respuesta pasaron de picos de 7.692 ms a 147 ms … en otras palabras, he ganado una velocidad de 52X …
Y veamos ahora qué ocurre con los gráficos en HTTPS que pasan a través de CloudFlare…
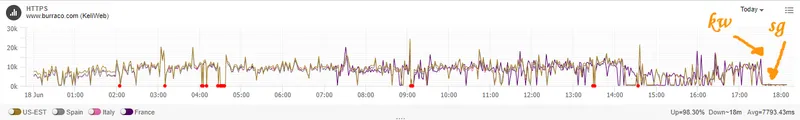
Se pasa de 14.117 ms (es decir, 14 segundos) a 505 ms (¡es decir, medio segundo!)… en otras palabras, he ganado una velocidad 28X superior… como mínimo.
Sin embargo, no hay que cantar victoria demasiado pronto ... hay que decir que podría haber un problema ligado a los tiempos de propagación de los DNS por el cambio de la IP del host, y por tanto monitis podría estar monitorizando un sitio al que solo llega una parte de las peticiones (porque las demás seguirían llegando al viejo servidor)... pero también es verdad que aproximadamente una semana antes de todo este análisis ya había bajado los TTL de los registros DNS individuales a pocos minutos (en previsión...), pero igualmente es verdad que muchos proveedores pasan de las RFC sobre los DNS (uno entre todos, fastweb) y por eso preferí esperar varias horas más para que se actualizaran también los DNS más rezagados, y estos son los resultados:
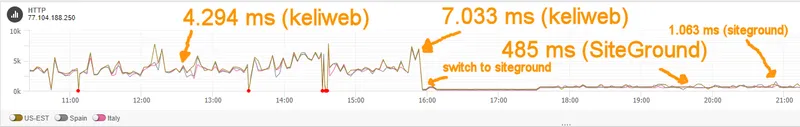
Para las peticiones en HTTP, en la práctica he pasado de una media de 4.294 ms con picos en torno a 6.000 / 7.000 ms (es decir, 7 segundos), a una media de 485 ms con picos mucho menos recurrentes en torno a 1.063 ms… digamos que la ganancia en términos de relación es en cualquier caso de 10X aproximadamente, y además estéticamente tengo un gráfico mucho más coherente, lineal y menos histérico... señal adicional de que mi rendimiento se veía probablemente afectado por algún otro cliente.
Echemos un vistazo también a la diferencia en HTTPS:
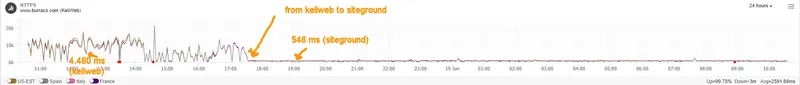
Hemos pasado de una media de 4.480 ms, con picos a menudo en torno a 15.000 ms (sin contar ese único pico de más de 20 segundos) a una media de 546ms con picos de aproximadamente 1 segundo. También aquí la ganancia media es de 10X pero si consideramos la frecuencia de los picos de más de 10 segundos, la ganancia en este caso es de unas 20X…
Después de todos estos análisis y consideraciones, los puntos clave que he sacado, a partir de la experiencia vivida, fueron estos:
1) Keliweb podría resultar muy lenta cuando se utiliza como alojamiento compartido, y cuando ocurre está poco interesada en encontrar las causas de las eventuales ralentizaciones de un único sitio web, apuntando siempre a ofrecer como solución un alojamiento dedicado. Lo cual no es erróneo desde el punto de vista comercial, si la culpa es efectivamente del cliente que consume demasiados recursos, pero se convierte en una verdadera injusticia si la culpa es... de otro y yo me veo obligado a pasar al alojamiento dedicado por ese motivo ! Aunque el soporte responde con rapidez, si vuestro problema es el rendimiento, hay otros que tomar en consideración como SiteGround (objeto principal de este análisis) pero también Godaddy.
2) SiteGround y Godaddy son ambas alternativas validísimas, que en mis pruebas no tuvieron los problemas que sí tuve en Keliweb.
Invito a Keliweb, si le interesa, a contactarme o a responder aquí si he omitido algún detalle o no he considerado algo importante (¡lo cual siempre puede ocurrir)!
Doy las gracias a todos los que han tenido la paciencia de leer el artículo hasta aquí y… ¡espero comentarios !
Si te apetece hablar de ello, escríbeme.
info@bitnrg.com
Comentarios
John
Superb material. Many thanks.
Michael
You actually stated that perfectly.